جهش GLM-5.3 از کجا آمد؟ خواندن دقیق یک بهروزرسانی بدون مدل پایهی تازه
معرفی رسمی GLM-5.3 با یک جملهی غیرعادی شروع میشود: مدل پایه عوض نشده و هر چه هست از مرحلهی دوم آموزش آمده. این ادعا برخلاف بیشتر ادعاهای بازاریابی آزمودنی است، چون سازنده جدول کامل سنجهها را کنار نسل قبل منتشر کرده. در این مقاله همان جدول را ردیفبهردیف میخوانیم — نه برای رد کردن ادعا، که در بیشتر ردیفها درست است، بلکه برای دیدن چیزی که میانگینها پنهانش میکنند: پیشرفت اصلاً یکدست نیست، و شکلِ ناهمواریاش دقیقاً میگوید پسآموزش چه کاری میکند و چه کاری نمیکند.
اول، اندازهی جهش
جدول زیر همان اعداد رسمی است، اینبار مرتبشده بر اساس اندازهی تغییر. هر دو ستون از یک منبعاند و هر دو مدل یک مدل پایه دارند، پس ستون آخر تقریباً خالصترین اندازهگیریِ «پسآموزش چقدر ارزش داشت» است که میشود به دست آورد.
| سنجه | GLM-5.2 | GLM-5.3 | تغییر |
|---|---|---|---|
| ExploitBench | ۲۴٫۴ | ۵۴٫۴ | +۳۰٫۰ |
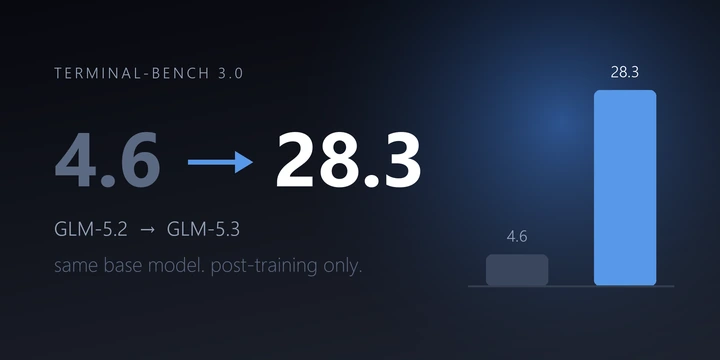
| Terminal-Bench 3.0 | ۴٫۶ | ۲۸٫۳ | +۲۳٫۷ |
| SWE-Marathon v1.1 | ۱۹٫۴ | ۴۲٫۵ | +۲۳٫۱ |
| AutomationBench | ۲۶٫۲ | ۴۸٫۲ | +۲۲٫۰ |
| DeepSWE v1.1 | ۴۶٫۲ | ۶۶٫۹ | +۲۰٫۷ |
| Toolathlon Verified | ۵۹٫۹ | ۷۳٫۰ | +۱۳٫۱ |
| FrontierSWE | ۶۷٫۵ | ۷۸٫۱ | +۱۰٫۶ |
| ProgramBench | ۹٫۵ | ۱۹٫۰ | +۹٫۵ |
| NL2Repo | ۴۸٫۹ | ۵۸٫۰ | +۹٫۱ |
| PostTrainBench | ۳۱٫۷ | ۳۹٫۸ | +۸٫۱ |
| HLE با ابزار | ۵۴٫۷ | ۶۲٫۵ | +۷٫۸ |
| CyberGym | ۷۷٫۲ | ۸۴٫۵ | +۷٫۳ |
| Terminal-Bench 2.1 | ۸۱٫۰ | ۸۸٫۲ | +۷٫۲ |
| Agents' Last Exam | ۲۳٫۸ | ۲۸٫۵ | +۴٫۷ |
سه نکته بلافاصله از این ترتیب بیرون میزند. یک: بازهی تغییر بسیار پهن است، از ۴٫۷ واحد تا ۳۰ واحد. دو: پرجهشترین ردیفها همه از یک جنساند — کارهای طولانی و چندمرحلهای که مدل باید تا انتها دنبالشان کند. سه: کمجهشترینها هم از یک جنساند — سنجههایی که مدل قبلاً هم در آنها امتیاز بالایی داشت یا پاسخ نسبتاً کوتاهی میخواهند.
این دقیقاً همان الگویی است که از تمرین — و بهطور مشخص از یادگیری تقویتی — انتظار میرود. تمرین، سقف توانایی را بالا نمیبرد؛ فاصلهی میان آنچه مدل «میتواند» و آنچه عملاً «انجام میدهد» را کم میکند. هرجا این فاصله بزرگ بوده — کارهای طولانی که مدل وسطشان رها میکرد — جای زیادی برای بهبود وجود داشته. هرجا فاصله از قبل کوچک بوده، جهش هم کوچک است.
وقتی نمرهای از ۴٫۶ به ۲۸٫۳ میرسد، وسوسهی اول این است که فکر کنیم مدل شش برابر باهوشتر شده. توضیح سادهتر معمولاً درستتر است: مدل قبلی همین کار را بلد بود و نیمهکاره رهایش میکرد.
— تیم هوشواره
سنجهای که در آن اول است، دقیقاً چه میسنجد؟
معرفی رسمی با توانایی امنیتی مدل شروع میشود و این انتخاب بیراه نیست — GLM-5.3 در آن ردیف واقعاً صدرنشین است. اما اگر همانجا بایستید، تصویر ناقصی برمیدارید. سه سنجهی امنیتی در جدول هست و این سه، سه کار متفاوت را میسنجند:
| سنجه | کار مدل چیست | GLM-5.3 | Claude Fable 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| CyberGym | نقص برایش توصیف شده؛ باید بازتولیدش کند | ۸۴٫۵ | ۸۳٫۸ | ۸۳٫۶ |
| ExploitBench | باید خودش راه بهرهبرداری را بسازد | ۵۴٫۴ | ۷۸٫۰ | ۷۶٫۵ |
| ExploitGym (۶ ساعت) | تعداد کار تمامشده در بودجهی زمانی | ۱۳۰ | ۲۴۷ | ۲۹۳ |
ستون دوم همهچیز را توضیح میدهد. در سنجهای که مدل اول است، صورتِ مسئله به او داده شده: این نقص وجود دارد، ثابتش کن. در دو سنجهای که عقب است، باید خودش راه را پیدا و بنا کند — و آنجا فاصلهاش با پرچمداران بسته حدود ۲۴ واحد است، نه یکرقمی.
جالبتر اینکه در همین ردیفها بیشترین رشد را هم داشته: ExploitBench بیش از دو برابر شده. یعنی همزمان دو چیز درست است — سریعترین رشد و بزرگترین عقبماندگی در یک نقطهاند. مدل دارد سریع نزدیک میشود، ولی هنوز فاصلهی زیادی مانده.
امتیاز بالا در سنجهای که مسئله را برایتان تعریف کرده، همان توانایی نیست که در مسئلهی تعریفنشده لازم دارید. اولی «اجرا»ست و دومی «تشخیص» — و کار واقعی معمولاً از دومی شروع میشود.
نکتهای که به نفع سازنده باید گفت
انصاف حکم میکند این را هم بنویسیم: خودِ معرفی رسمی این ضعف را پنهان نکرده. آنها صریحاً مینویسند هرچه سنجه بالاتر در زنجیرهی بهرهبرداری بایستد، هم جهش نسبت به نسل قبل بزرگتر است و هم فاصلهی باقیمانده تا رقبای بسته بیشتر — و نتیجه میگیرند توانایی مدل دقیقاً همانجا سریعترین رشد را دارد که خودشان از همه عقبترند.
چنین جملهای در یک متن معرفی محصول کمسابقه است و اعتبار بقیهی اعداد را بالا میبرد. تفاوت خواندن ما با معرفی رسمی، تفاوت در واقعیتها نیست؛ تفاوت در این است که کدام واقعیت اول میآید.
بهای این جهش
یک ردیف در این ماجرا هست که در هیچ جدول بنچمارکی نمیآید: تعرفه. GLM-5.3 نسبت به نسل قبلِ خودش حدود یکونیم برابر گرانتر است، روی ورودی و خروجی با همان نسبت. معرفی رسمی این را برجسته نمیکند، ولی برای شما که ماهانه صورتحساب میبینید از نصف ردیفهای جدول مهمتر است.
در عوض یک اثر مخالف هم هست: مدل همان کار را با توکن کمتری تمام میکند. به گزارش سنجهی داخلی سازنده، مصرف توکن خروجی در هر کار از حدود ۹۶ هزار به حدود ۷۵ هزار رسیده، یعنی حدود یکپنجم کمتر. حاصلضرب این دو را که بگیرید، هزینهی خروجیِ یک کارِ تمامشده تنها حدود ۱۳ درصد بالا میرود، در حالی که نرخ اتمام همان کار از ۲۳٫۴ به ۳۴٫۵ درصد رفته است.
پس جمعبندی اقتصادیاش این است: برای کارهای چندمرحلهای ارتقا بهصرفه است، چون گرانیِ هر توکن را کاهش تعداد توکنها تا حد زیادی خنثی میکند و نرخ موفقیت بهمراتب بالاتر میرود. برای پرسشوپاسخ ساده و متن کوتاه، شما فقط تعرفهی بالاتر را میپردازید و هیچکدام از آن جهشها را نمیبینید — چون هیچکدامشان در آن دسته کار اتفاق نیفتادهاند.
این برای کار شما یعنی چه؟
- اگر کارتان چندمرحلهای است — کدنویسی در یک پروژهی واقعی، رفع باگ، خودکارسازی یک گردشکار — بیشترین بهره را از این نسخه میبرید. جهشها همگی همینجا بودهاند.
- اگر کارتان یک پاسخ کوتاه است — ترجمه، خلاصه، دستهبندی — ارتقا احتمالاً چیزی به شما نمیدهد و فقط تعرفهی بالاتر را میپردازید. نسل قبل یا یک مدل سبک انتخاب سنجیدهتری است.
- اگر به سنجهها تکیه میکنید، پیش از هر چیز بپرسید آن سنجه دقیقاً چه کاری از مدل خواسته است. همانطور که دیدیم، دو سنجه با برچسب یکسان میتوانند دو توانایی کاملاً متفاوت را اندازه بگیرند.
و مطمئنترین راه همچنان این است که خودتان امتحان کنید: در آرنای مدلها همان درخواست واقعیتان را همزمان به نسل قبل و این نسخه بدهید و کیفیت و هزینه را کنار هم ببینید.
پرسشهای متداول
پس بالاخره GLM-5.3 پیشرفت کرده یا نه؟
بله، و در بعضی ردیفها خیلی زیاد. حرف این مقاله این نیست که پیشرفتی نبوده؛ این است که پیشرفت یکدست نبوده و جای آن کاملاً قابل پیشبینی است — هرجا کار طولانی و چندمرحلهای بوده جهش بزرگ، هرجا پاسخ کوتاه بوده جهش کوچک.
چرا اصلاً مهم است که مدل پایه عوض نشده؟
چون به شما میگوید از این نسخه چه انتظاری داشته باشید. پایهی تازه در یک مدل زبانی بزرگ معمولاً یعنی دانش و توان استدلال بیشتر؛ پسآموزشِ بیشتر یعنی همان توان، بهتر بهکار گرفته میشود. اگر مسئلهی شما «مدل بلد نیست» باشد، این نسخه لزوماً حلش نمیکند؛ اگر مسئله «بلد است ولی نیمهکاره رها میکند» باشد، دقیقاً همین را حل کرده است.
یعنی اعداد امنیتی معرفی رسمی گمراهکنندهاند؟
نه، اعداد درستاند و خودِ سازنده هم فاصلهی باقیمانده را نوشته است. نکته این است که صدرنشینی در ردیفِ «تشخیص» را نباید به توانمندی در ردیفِ «بهرهبرداری» تعمیم داد؛ در آن دو ردیف مدل هنوز بهروشنی عقب است.
این تحلیل با مقالهی معرفی شما چه فرقی دارد؟
آن یکی مشخصات، بنچمارکها و مقایسهی هزینه را کامل مرور میکند و برای انتخاب مدل نوشته شده؛ این یکی فقط روی خواندن دقیق همان اعداد تمرکز دارد. اگر هنوز نخواندهاید، از معرفی کامل GLM-5.3 شروع کنید.
جمعبندی
ادعای سازنده درست است: بدون عوضکردن مدل پایه هم میشود جهش گرفت، و در کارهای طولانی و چندمرحلهای این جهش واقعی و بزرگ است. اما همان جدول چیز دیگری هم میگوید — تمرین، فاصلهی «میتواند» تا «انجام میدهد» را کم میکند و نه سقف توانایی را. برای انتخاب مدل، این تفاوت عملیترین چیزی است که میشود از یک جدول بنچمارک بیرون کشید.
راه مطمئن قضاوت هم همان همیشگی است: کار واقعی خودتان. فهرست مدلها و تعرفهی تومانی هرکدام در کاتالوگ مدلها و طرحهای اشتراک در صفحهی تعرفهها است. حساب ندارید؟ ثبتنام کمتر از یک دقیقه طول میکشد.